7 phút đọc
Trong bối cảnh các mối đe dọa an ninh mạng liên tục biến đổi, thông tin tình báo mối đe dọa (Threat Intelligence) từ cộng đồng đóng vai trò vô cùng quan trọng giúp các doanh nghiệp nhanh chóng phát hiện và ngăn chặn các cuộc tấn công. Repository 0xDanielLopez/TweetFeed là một giải pháp mã nguồn mở thu hút sự quan tâm lớn từ cộng đồng an toàn thông tin (Infosec) với 680 stars và 68 forks trên GitHub, ghi nhận cập nhật gần đây vào ngày 01/09/2026. Dự án đóng vai trò như một bộ thu thập tự động các Chỉ số Thỏa hiệp (Indicators of Compromise – IOCs) được chia sẻ bởi các chuyên gia bảo mật trên mạng xã hội Twitter/X.
Tự động hóa thu thập dữ liệu IOCs đa định dạng
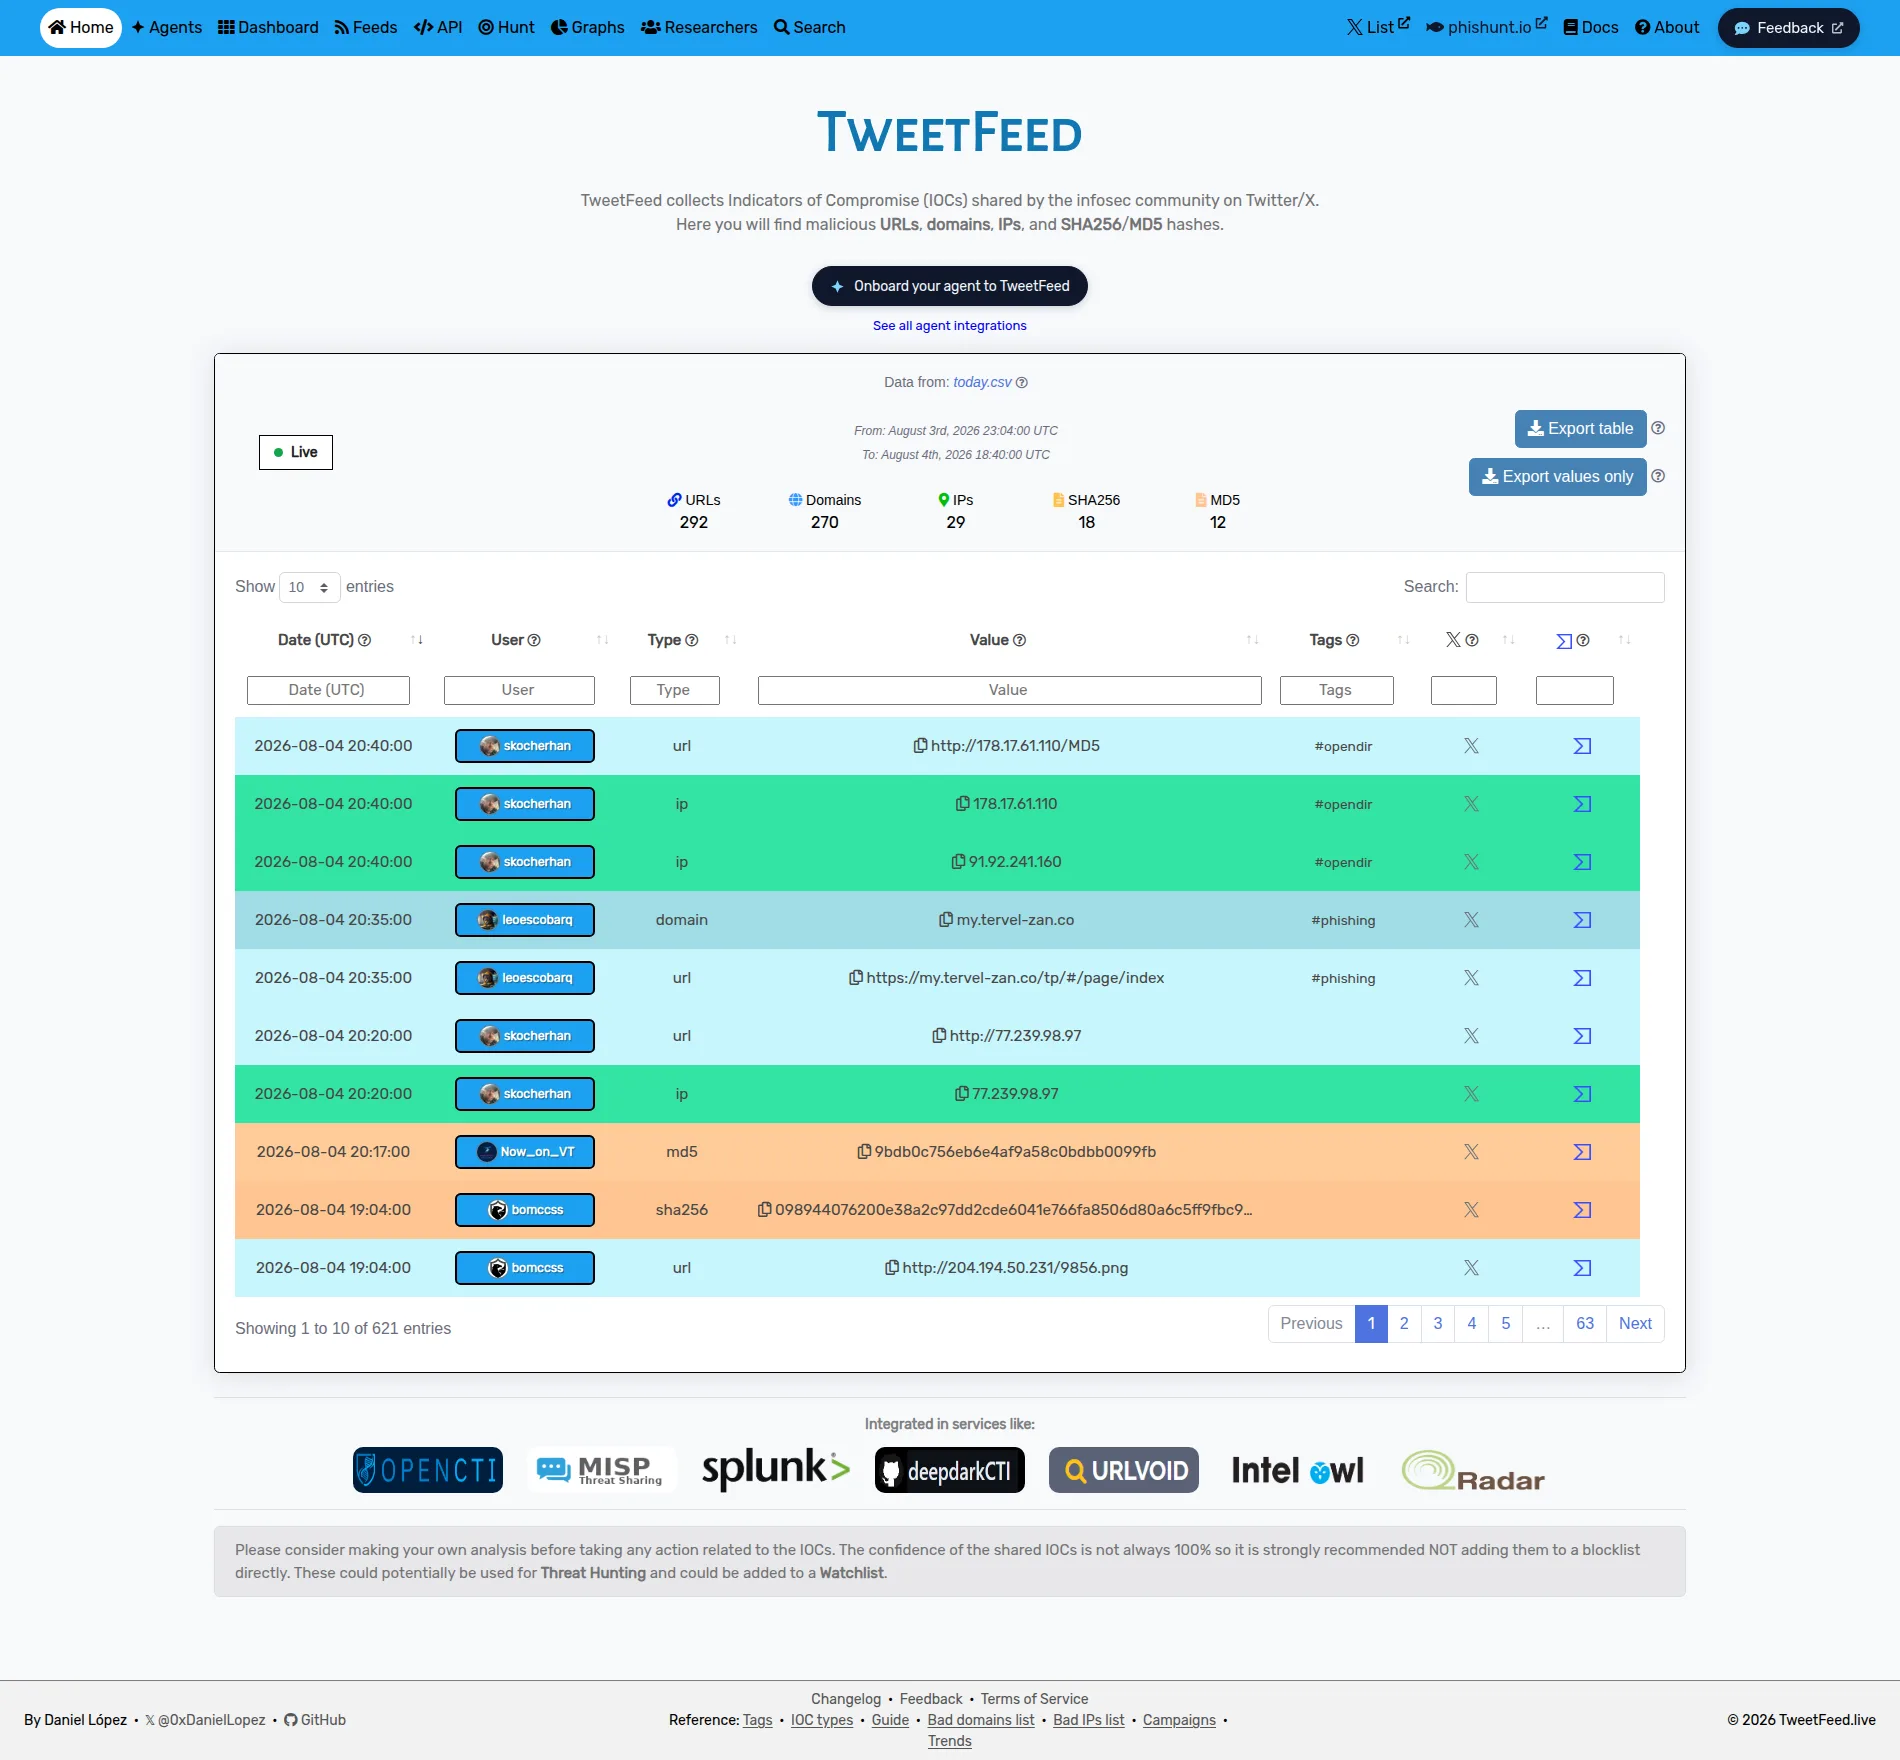
Dự án TweetFeed được xây dựng với mục tiêu chuyển hóa các chia sẻ phân tán của cộng đồng bảo mật trên Twitter/X thành các nguồn dữ liệu có cấu trúc và có thể ứng dụng ngay lập tức. Hệ thống pipeline tự động của TweetFeed thực hiện quét, phân tích và tái tạo các bộ đếm dữ liệu (bao gồm mốc thời gian, tổng số lượng theo từng loại, số lượng nhãn tag, các tag hoạt động nhiều nhất và những tài khoản báo cáo hàng đầu) định kỳ mỗi 15 phút. Các IOCs được thu thập bao gồm các URL độc hại, tên miền (domains), địa chỉ IP, cùng các mã băm SHA256 và MD5.
Người dùng có thể tiếp cận nguồn dữ liệu này dưới nhiều định dạng khác nhau tùy thuộc vào hạ tầng bảo mật sẵn có, bao gồm CSV, JSON, RSS, MISP, STIX, TAXII và các danh sách chặn (blocklist) được dựng sẵn. Một điểm lưu ý kỹ thuật quan trọng khi xử lý dữ liệu định dạng CSV từ TweetFeed là tệp tin không chứa dòng tiêu đề (header row). Dòng đầu tiên của tệp tin đã chứa dữ liệu thực tế, do đó khi lập trình xử lý, người dùng không được cấu hình bỏ qua dòng đầu tiên để tránh làm mất mát các chỉ số IOCs quan trọng.
Khả năng tích hợp linh hoạt vào các hệ thống SIEM và EDR chuyên nghiệp
Một trong những ưu điểm nổi bật giúp TweetFeed nhận được đánh giá cao là khả năng tương thích sâu với nhiều nền tảng giám sát an ninh thông tin phổ biến:
- Microsoft Sentinel: Các kỹ sư an ninh mạng có thể sử dụng ngôn ngữ truy vấn KQL để đối chiếu dữ liệu từ TweetFeed với nhật ký hoạt động của hệ thống. Chẳng hạn, so khớp mã băm SHA256 từ nguồn cấp dữ liệu theo năm (yearly feed) với bảng lưu vết tiến trình, hoặc đối chiếu IP từ nguồn cấp theo tháng (monthly feed) và URL/tên miền từ nguồn cấp theo tuần (weekly feed) với lưu lượng mạng.
- Splunk: Dự án hỗ trợ lập lịch nhập tệp CSV định kỳ thông qua Add-on Builder hoặc REST modular input theo chu kỳ 15 phút trùng với tần suất cập nhật của nguồn tin. Do tệp CSV không có tiêu đề, người quản trị cần khai báo thủ công danh sách các trường trong cấu hình
transforms.confbao gồm: date (ngày theo chuẩn UTC), user (người dùng chia sẻ trên Twitter), type (loại chỉ số), value (giá trị IOC), tags (các nhãn phân tách bằng khoảng trắng) và tweet (liên kết đến bài đăng gốc). - Elastic Stack và OpenSearch: Người dùng có thể sử dụng Logstash để kéo dữ liệu CSV về chỉ mục (index) sau mỗi 15 phút. Bằng cách kết hợp trường định danh tài liệu và tính năng cập nhật nếu đã tồn tại (doc_as_upsert), hệ thống sẽ tránh được hiện tượng trùng lặp dữ liệu khi nạp chồng các khoảng thời gian. Sau đó, việc đối chiếu được thực hiện qua ngôn ngữ ES|QL trong Kibana. Ngoài ra, TweetFeed cung cấp đầu vào TAXII 2.1 nguyên bản (mã collection: b7dc78af-1d12-5059-898c-3f0e77636204, không yêu cầu xác thực) để tự động ánh xạ các chỉ số vào cấu trúc dữ liệu chuẩn của Elastic. Đối với OpenSearch, khung phân tích bảo mật hỗ trợ tiêu thụ thông qua STIX bundles hoặc chính endpoint TAXII này.
Triển khai blocklist DNS trực tiếp cho mạng nội bộ
Đối với các quản trị viên muốn triển khai giải pháp ngăn chặn nhanh ở mức mạng, TweetFeed cung cấp sẵn 7 danh sách chặn được biên dịch tự động trong phạm vi cửa sổ 30 ngày gần nhất và cập nhật sau mỗi 15 phút. Người dùng chỉ cần trỏ trực tiếp các trình phân giải tên miền (DNS resolver) nội bộ vào các liên kết do dự án cung cấp:
- Pi-hole: Thêm đường dẫn URL của tệp
domains.txtvào mục cấu hình Adlists và thực hiện cập nhật cơ sở dữ liệu. - AdGuard Home: Thêm danh sách chặn tùy chỉnh bằng cách dán URL của tệp
adguard.txtvào phần cấu hình bộ lọc DNS.
Để tối ưu hóa băng thông mạng và hiệu năng của hệ thống tự động tải dữ liệu, TweetFeed khuyến nghị các công cụ tải dữ liệu nên hỗ trợ cơ chế phản hồi có điều kiện HTTP thông qua thẻ If-None-Match. Khi không có dữ liệu mới phát sinh, máy chủ sẽ phản hồi mã trạng thái 304 để tránh việc tải lại toàn bộ danh sách trùng lặp.
Do các chỉ số này được thu thập trực tiếp từ cộng đồng mạng xã hội và chỉ đi qua các bộ lọc tự động của riêng TweetFeed mà không có thêm một cổng kiểm duyệt uy tín độc lập nào khác, nhà phát triển đưa ra khuyến cáo quan trọng: người dùng nên triển khai dữ liệu này ở chế độ giám sát và ghi nhận nhật ký (monitoring/logging mode) trước khi áp dụng cấu hình chặn cứng trên các hạ tầng mạng sản xuất có mật độ người dùng cao để tránh hiện tượng chặn nhầm (false positive).
Những khía cạnh chưa được làm rõ của dự án
Mặc dù TweetFeed cung cấp một phương thức hiệu quả và nhanh chóng để tiếp cận nguồn tri thức an ninh từ Twitter/X, trang dự án hiện tại vẫn chưa công bố thông tin chi tiết về ngôn ngữ lập trình chính được sử dụng để xây dựng nên toàn bộ hệ thống pipeline thu thập tự động này. Ngoài ra, cơ chế lọc nội dung cụ thể (các quy tắc lọc để loại bỏ tin rác hoặc thông tin sai lệch trước khi đưa vào feed) của TweetFeed cũng chưa được mô tả chi tiết trong tài liệu kỹ thuật, khiến người dùng khó đánh giá sâu hơn về mức độ tin cậy nội tại của dữ liệu thu được trước khi quyết định tích hợp sâu vào hệ thống bảo mật cốt lõi.
Nguồn tham khảo: Xem bài gốc